 GIBRID.AISekolah
Mode Otomatis: model cepat untuk hal sederhana, model kuat untuk yang sulit
Chat baru di gibrid.ai/chat dimulai dengan mode Otomatis: untuk setiap pesan, Gibrid memilih modelnya sendiri. Sapaan, terjemahan, atau pertanyaan singkat masuk ke model cepat yang murah; file, kode, atau dokumen masuk ke model kuat. Baris di bawah jawaban menyebut dengan jujur model mana yang menjawab, dan harganya terlihat di samping tombol kirim sebelum Anda mengirim.
- Di chat web gibrid.ai/chat, mode Otomatis aktif secara bawaan jika Anda belum pernah memilih model sendiri. Untuk tiap pesan server memakai model cepat (Gemini 3.8 Flash) atau model kuat (Claude Sonnet 5.5).
- Di bawah jawaban ada baris seperti “Otomatis · model cepat · Gemini 3.8 Flash”, jadi terlihat model mana yang menjawab dan alasannya.
- Untuk memilih model sendiri: tombol mode di bawah kolom input → baris Model → model apa pun di daftar. “Otomatis” adalah baris tersendiri di bagian atas daftar itu.
- Di samping tombol kirim ada chip “≈ N G” berisi harga pesan berikutnya; untuk Otomatis berupa rentang, misalnya “≈ 0,5–1,6 G”. Pada 10 G ke atas chip menjadi lebih terang dan menyarankan model cepat atau chat baru.
- Jika jawaban terpotong karena panjang, klik Lanjutkan. Awal percakapan yang sangat panjang diringkas supaya asisten tidak lupa apa yang sudah dibahas.
1Cara Otomatis memilih model
Keputusan dibuat di server dari kata-kata pesan Anda dan lampirannya, tanpa panggilan AI tersendiri. Jadi Otomatis tidak menambah harga dan tidak memperlambat jawaban.
| Tingkat | Model yang dipakai (berurutan) | Kapan |
|---|---|---|
| Cepat | Gemini 3.8 Flash; jika tidak tersedia, GPT-6 Luna, lalu Claude Haiku 5.5 | pesan sehari-hari: sapaan, pertanyaan singkat, terjemahan, ide, ucapan selamat, berita terbaru dengan pencarian web |
| Kuat | Claude Sonnet 5.5, lalu Claude Sonnet 5, Claude Sonnet 4.6, Claude Sonnet 4 | ada sinyal tugas yang rumit (lihat daftar di bawah) |
Model kuat diaktifkan oleh sinyal-sinyal berikut:
- ada file atau gambar yang dilampirkan ke pesan;
- topiknya video, dokumen dan tabel, storyboard, pembuatan persona, soul dan agen, pengiriman massal, akun, pembayaran, atau dukungan, atau Anda secara eksplisit meminta menggambar (asisten mengenali topik dari kata kuncinya);
- Anda meminta jadwal atau pengulangan (“ingatkan saya”, “setiap hari…”);
- teksnya berisi kode atau istilah pemrograman (fungsi, error, Python, SQL, dan sejenisnya);
- Anda meminta berpikir atau membandingkan (“pikirkan”, “bandingkan”, “analisis”, “plus dan minus”);
- percakapan panjang (riwayat lebih dari sekitar 24.000 karakter) atau pesan yang sangat panjang (lebih dari 6.000 karakter);
- mode Riset aktif (laporan dari banyak sumber).
Kata tentang gambar dan jadwal hanya menaikkan model jika berupa permintaan yang jelas. Misalnya, “Terjemahkan: rapat besok jam 10 pagi” tetap di model cepat: kata “besok” saja bukan sinyal.
Setelah percakapan menjadi “kuat”, ia tetap kuat selama 6 jam: tanpa sinyal baru modelnya tidak dinaikkan, dan di tengah percakapan sulit modelnya tidak diturunkan diam-diam. Jika suatu model terkunci oleh paket Anda, Otomatis memakai model berikutnya di daftarnya.
2Baris di bawah jawaban: siapa yang menjawab
Di bawah setiap jawaban dalam mode Otomatis ada baris kecil berwarna abu-abu. Untuk pesan biasa bunyinya “Otomatis · model cepat · Gemini 3.8 Flash”. Untuk pesan sulit: “Otomatis · model kuat (kode) · Claude Sonnet 5.5”. Alasannya ada di dalam tanda kurung: “file”, “alat”, “kode”, “tugas sulit”, “teks panjang”, atau “lanjutan percakapan”.
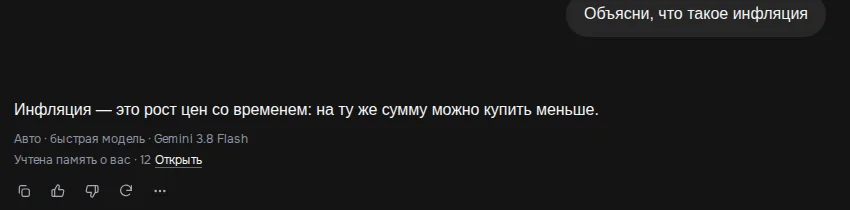
Arahkan kursor ke baris itu dan muncul petunjuk: “Otomatis memilih model untuk pesan ini. Untuk mematikan, pilih model di daftar.” Tombol Lanjutkan (saat jawaban terpotong) melanjutkan jawaban dengan model yang sama yang memulainya.
3Cara memilih model tertentu atau kembali ke Otomatis
- Buka menu mode
Di chat baru, klik tombol di bawah kolom input di sebelah kanan. Tertulis “Auto”, “Cepat”, atau “Berpikir”: itu mode kedalaman berpikir, bukan pilihan model.
- Klik baris “Model”
Daftar model per pengembang terbuka. Di bagian paling atas ada baris tersendiri Otomatis dengan keterangan “Memilih untukmu: model cepat untuk pertanyaan biasa, model kuat untuk file, alat, dan tugas sulit” beserta rentang harga.
- Pilih Otomatis atau model apa pun
Pilihan diingat: untuk chat ini dan untuk chat baru. Dengan model yang Anda pilih sendiri, Otomatis tidak ikut campur dan baris “Otomatis · …” tidak muncul di bawah jawaban.
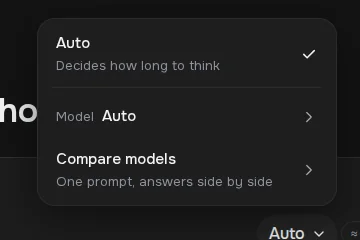
Jika sebelumnya Anda memilih model sendiri, model itu tetap terpilih: Otomatis hanya menjadi bawaan di tempat yang belum pernah dipilih. Otomatis bekerja di versi web; aplikasi seluler Gibrid masih menjawab dengan model bawaan sebelumnya. Untuk membandingkan beberapa model pada satu pertanyaan, lihat halaman tentang membandingkan model.
4Berapa biayanya: chip “≈ N G” di samping tombol kirim
Di sebelah kiri tombol kirim di kolom input ada chip kecil berisi harga pesan berikutnya, misalnya “≈ 0,5–1,6 G”. G sama dengan token ⚡ (1 ⚡ ≈ $0,025). Harga dihitung lebih dulu dengan rumus yang sama dengan yang nanti dipakai untuk memotong saldo Anda:
- bagian bawaan dari permintaan asisten (instruksi dan deskripsi alatnya): sekitar 12.000 token;
- ditambah riwayat chat ini (sekitar 1 token per 3,2 karakter) dan lampiran (1.500 token per lampiran);
- ditambah jawaban tipikal model tersebut; harga diambil dari tabel harga model dengan markup paket Anda;
- koreksi per model: sekali sejam server mencocokkan perkiraan dengan pemotongan sebenarnya selama 14 hari.
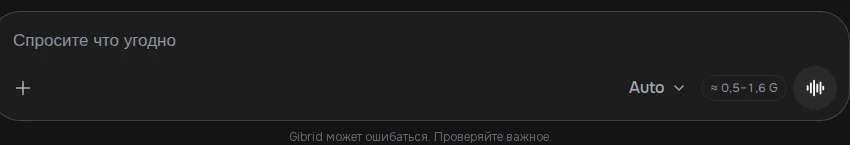
Untuk Otomatis chip menampilkan rentang dari model cepat sampai model kuat. Jumlah pastinya baru diketahui setelah jawaban: bergantung pada tingkat mana yang dipilih Otomatis dan panjang jawabannya. Untuk model yang Anda pilih sendiri chip menampilkan satu angka. Harga yang sama (“≈ N G di chat ini”) tertera di setiap baris daftar model, sehingga model yang mahal terlihat sebelum dipilih.
| Yang terlihat | Artinya |
|---|---|
| ≈ 0,5–1,6 G | rentang Otomatis di chat kosong: angka bawah untuk model cepat, angka atas untuk model kuat. Di chat Anda angkanya bergantung pada paket (makin rendah markup, makin kecil jumlahnya) dan panjang percakapan |
| Chip lebih terang dan petunjuk “Pesan di chat ini mahal” | perkiraan mencapai 10 G atau lebih. Biasanya karena riwayat yang panjang. Model cepat atau chat baru akan lebih murah |
| Tidak ada chip | harga untuk model ini belum terhitung (misalnya tidak ada koneksi ke server) |
5Jawaban terpotong: tombol “Lanjutkan”
Dulu jawaban bisa terpotong di tengah kata karena batas panjang. Sekarang batasnya diambil dari kemampuan model, tetapi tidak lebih dari 16.000 token (sampai 32.000 dengan berpikir mendalam). Jika jawaban tetap mentok di batas itu, di bawahnya muncul baris: “Jawaban terpotong karena panjang · Lanjutkan”.
- Klik “Lanjutkan”
Asisten melanjutkan jawaban dari titik berhentinya, tanpa mengulang dan tanpa salam.
- Terus baca di gelembung yang sama
Lanjutannya ditambahkan ke jawaban yang sama. Kalimat layanan “lanjutkan” tidak masuk ke riwayat chat.
Lanjutannya ditulis oleh model yang sama yang menulis bagian awal. Biayanya adil: hanya token lanjutan yang dipotong, dan di “biaya jawaban” jumlahnya digabung dengan bagian pertama. Tombol hanya muncul pada jawaban terakhir percakapan.
6Percakapan panjang: awalnya diringkas
Model tidak melihat seluruh percakapan, hanya pesan terbaru yang muat di jendelanya (chat web mengirim sampai 30 pesan). Dulu semua yang lebih awal begitu saja hilang, dan asisten menjawab “seperti yang saya bilang di awal…” dengan melenceng. Sekarang yang tidak muat diringkas oleh model Gemini Flash yang murah menjadi ringkasan singkat (paling banyak 1.200 karakter) dan diteruskan ke asisten bersama pertanyaan Anda.
Di bawah jawaban muncul baris: “Awal percakapan (24 pesan) diringkas · Tampilkan”. Klik Tampilkan untuk membaca ringkasannya dan Sembunyikan untuk melipatnya.
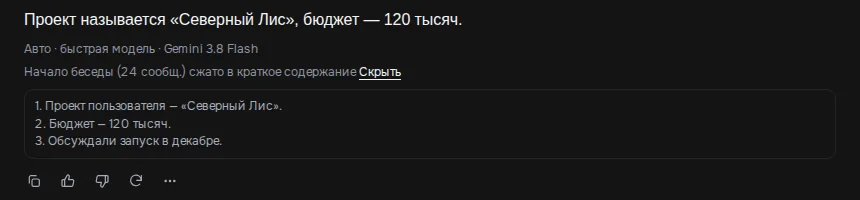
- ringkasan disimpan dan dihitung ulang bukan di setiap pesan, melainkan saat terkumpul sekitar 12 pesan baru yang “terlewat”;
- biaya peringkasan sudah termasuk dalam biaya jawaban Anda; tidak ada baris terpisah di saldo;
- di chat sementara (dibahas di halaman tersendiri) peringkasan tidak dilakukan, karena riwayat tidak disimpan;
- tidak ada tawaran “chat baru dengan ringkasan”: saat pesan menjadi mahal (10 G ke atas), chip harga sendiri menyarankan memulai chat baru.
7Petunjuk fitur di bawah jawaban
Kadang di bawah jawaban terakhir muncul satu petunjuk singkat. Tiap jenis ditampilkan paling sering sekali sehari, dan bisa ditutup dengan tanda silang:
| Kapan muncul | Apa yang disarankan | Apa yang dilakukan tombolnya |
|---|---|---|
| Anda menulis “setiap hari…”, “setiap pagi…”, “harian” atau “mingguan” (rumusan bahasa Rusia dan Inggris juga dihitung) | “Ini bisa diulang sesuai jadwal” | Ulangi: meminta asisten mengubah permintaan menjadi tugas terjadwal |
| Anda menanyakan hal yang sama untuk ketiga kalinya | “Ini ketiga kalinya Anda menanyakan ini” | Simpan ke Prompt saya: menyimpan teksnya ke Prompt saya |
| Jawaban besar (mulai 1.500 karakter) di chat yang tersimpan | “Jawaban panjang — Anda bisa membagikan tautannya” | Bagikan: membuat tautan publik ke chat dan menyalinnya |
Di chat sementara petunjuk tidak ditampilkan. Lebih lanjut tentang tautan publik ada di halaman tentang berbagi chat.
8Yang tidak dilakukan Otomatis
- Tidak membaca pikiran. Pilihan didasarkan pada kata dan lampiran. Jika pertanyaan sulit ditulis sangat singkat dan tanpa kata “sinyal”, ia bisa masuk ke model cepat. Jelaskan tugasnya lebih rinci atau pilih model kuat sendiri.
- Tidak ada tombol “selalu kuat”. Jika Anda ingin tingkat yang sama setiap kali, pilih model tertentu di daftar.
- Tidak bekerja di aplikasi seluler. Untuk saat ini Otomatis ada di versi web gibrid.ai/chat.
- Tidak menjamin harga yang pasti. Chip hanyalah perkiraan; jumlah sebenarnya terlihat setelah jawaban: di menu “⋯” (Lainnya) di bawah jawaban ada baris “Biaya ≈ N G”.
?Pertanyaan umum
Apa itu Otomatis di chat Gibrid, dan apakah aktif secara bawaan?
Itu mode di mana model dipilih untuk setiap pesan: model cepat yang murah untuk pertanyaan sehari-hari, model kuat untuk file, kode, dokumen, dan tugas sulit. Di chat web gibrid.ai/chat mode ini aktif secara bawaan jika sebelumnya Anda belum memilih model sendiri. Baris di bawah jawaban menyebut model yang menjawab.
Bagaimana cara mematikan Otomatis?
Buka menu mode di bawah kolom input, klik “Model”, lalu pilih model tertentu sebagai ganti baris “Otomatis”. Pilihan itu diingat. Anda bisa kembali dengan cara yang sama: baris “Otomatis” ada di bagian atas daftar.
Mengapa kadang model kuat yang menjawab padahal pertanyaannya sederhana?
Ada sinyal yang aktif: file atau gambar terlampir, kata tentang kode, dokumen, jadwal, “pikirkan/bandingkan”, riwayat panjang, atau percakapan sudah menjadi “kuat” (tetap begitu selama 6 jam). Alasannya ada di dalam tanda kurung pada baris tersebut, misalnya “model kuat (file)”.
Berapa biaya satu pesan dalam mode Otomatis?
Rentangnya terlihat lebih dulu di chip di samping tombol kirim, misalnya “≈ 0,5–1,6 G”. Dalam pengukuran pada 12 pesan tipikal, balasan cepat berharga 0,19–0,45 G, sedangkan kode dan dokumen 2–2,6 G. Jumlah pastinya bergantung pada paket, panjang percakapan, dan jawaban.
Apa arti “Jawaban terpotong karena panjang”?
Model mencapai batas panjang jawaban (sampai 16.000 token, sampai 32.000 dengan berpikir mendalam). Klik “Lanjutkan”: asisten melanjutkan jawaban di gelembung yang sama dengan model yang sama, dan Anda hanya membayar untuk lanjutannya.
Asisten lupa awal percakapan yang panjang. Apa yang harus dilakukan?
Biasanya tidak perlu apa-apa: awalnya diringkas dan asisten memperhitungkannya (di bawah jawaban muncul baris “Awal percakapan … diringkas”). Jika kutipan yang tepat penting, ulangi di pesan atau buka chat baru.
Apakah Otomatis ada di aplikasi iPhone dan Android?
Belum: Otomatis bekerja di versi web. Aplikasi menjawab dengan model bawaannya, seperti sebelumnya.
Terkait
Percakapan pertama di chat Gibrid
Chat adalah layar utama Gibrid: satu kolom input, dan di bawahnya model seperti GPT, Claude, dan Gemini. Kita…
Selengkapnya →Bandingkan model: satu pertanyaan, jawaban berdampingan
Tidak tahu model mana yang paling cocok untuk tugas Anda? Layar “Bandingkan model” mengirim satu permintaan…
Selengkapnya →Riset di chat Gibrid: laporan dari sepuluh sumber
Saat Anda butuh bukan sekadar “cari di Google”, melainkan tinjauan pasar, perbandingan layanan, atau kajian…
Selengkapnya →File besar di chat Gibrid: cari di dalam dokumen
Dulu asisten hanya melihat bagian awal dokumen yang panjang, dan jawaban dari tengah atau akhir bisa…
Selengkapnya →Pembayaran, paket, dan saldo: cara kerjanya
Di Gibrid ada satu saldo untuk semuanya: chat, gambar, video, suara, dan agen. Saldo digunakan dalam G-token…
Selengkapnya →